Esta herramienta convierte PDFs escaneados en texto editable para que puedas copiar, editar y añadir contenido fácilmente.
o arrastra, pega o elige desde la nube


Convertir un PDF escaneado en texto en realidad son dos tareas distintas, y el conversor te permite elegir cuál ejecutar. Un PDF que ya contiene caracteres reales solo tiene que leerse. Un PDF que contiene imágenes de páginas primero debe reconocerse, porque todavía no hay texto dentro.
Puedes distinguirlos en un segundo. Abre el archivo en cualquier lector e intenta seleccionar una línea. Si las palabras se resaltan, el PDF tiene una capa de texto, así que elige Convertir y el texto saldrá exactamente como fue escrito. Si nada se resalta, o la página entera se resalta como un solo bloque, es un escaneo y necesita reconocimiento óptico de caracteres.
Esa sola elección explica la mayoría de los resultados decepcionantes que la gente obtiene en otros sitios. Un conversor que usa la misma ruta para cada archivo devuelve texto limpio para algunos archivos y una página vacía para otros, sin explicación en ningún caso. Elegir tú mismo el motor elimina las conjeturas.
Un escaneo no te permite arrastrar el cursor sobre una frase, porque no hay nada que seleccionar. Extraer el texto de un PDF escaneado resuelve eso: sube el archivo, ejecuta la conversión y obtendrás un archivo de texto sin formato desde el que puedes copiar, pegar en un correo electrónico o buscar con el comando de encontrar en cualquier editor.
La salida es un archivo .txt, por lo que se abre en cualquier ordenador y en cualquier teléfono sin software especial. Conserva las palabras y los saltos de línea y deja atrás el diseño, que es el equilibrio adecuado cuando lo que quieres es el contenido y no una copia de la página.
Puedes subir varios escaneos a la vez. Cada PDF se convierte por separado y se descarga como su propio archivo de texto, con el mismo motor y la misma selección de idioma aplicados a todos.
La extensión de archivo .txt se usa para archivos de texto sin formato. Estos archivos contienen líneas de texto y se pueden abrir en muchos editores de texto en diferentes plataformas y dispositivos. El texto no contiene ningún formato.
Por eso es el lugar más seguro para guardar texto recuperado de un escaneo. Nada en el archivo puede quedarse obsoleto, no hace falta una licencia para abrirlo y las palabras siguen siendo legibles mucho después de que el programa que creó el original haya sido reemplazado.
Extensión de archivo: .txt, tipo MIME: text/plain
TXT en WikipediaAquí hay 5 formas de leer un PDF escaneado y el panel de ajustes te permite cambiar entre ellas. Elige la que mejor se adapte al archivo que tienes delante.
| Motor de OCR | Elígelo cuando |
|---|---|
| Convertir | El PDF ya tiene texto seleccionable. No se ejecuta reconocimiento, por lo que las palabras salen exactamente como fueron escritas. |
| OCR estándar | El escaneo es limpio, recto y nítido. Es la forma más rápida de pasar de un PDF escaneado a texto. |
| OCR con IA avanzado | El escaneo es tenue, de baja resolución o está ligeramente torcido, y el motor estándar pierde caracteres. |
| OCR con IA avanzado+ | La página tiene sombras, iluminación desigual o el lomo curvado, algo habitual cuando se fotografía un libro. |
| OCR de fotos | El texto se ha fotografiado en lugar de escanearse, por ejemplo, un cartel, una etiqueta o una pantalla. |
El conversor reconoce 124 idiomas de origen, incluidos chino simplificado y tradicional con diseños verticales y las formas cirílicas de azerbaiyano, serbio y uzbeko. Selecciona todos los idiomas que aparezcan en tu archivo.
Las palabras de un escaneo están bloqueadas dentro de una imagen. Estas son las situaciones en las que extraerlas ahorra más trabajo.
Las facturas, contratos, recibos y cartas suelen llegar como escaneos. Con el texto extraído puedes buscar un importe, una fecha o un nombre en lugar de leer cada página.
Los escaneos de biblioteca, artículos de revistas y páginas de libros se vuelven citables. Extrae el texto una vez y pega los pasajes que necesites en tus notas en lugar de volver a teclearlos.
Los archivos antiguos suelen guardarse como escaneos largos y de varias páginas. Sube varios a la vez y el conversor procesará el lote en una sola ejecución.
Los papeles que escaneas y los documentos que conviertes pueden ser personales. Aquí se explica exactamente cómo se tratan los tuyos.
Todas las subidas y descargas usan una conexión cifrada, por lo que tus archivos no pueden leerse durante la transmisión.
El reconocimiento de texto está completamente automatizado. Nadie lee tus escaneos o documentos, y nada se comparte con terceros.
Stored on servers with full-disk encryption, and backups are encrypted too.
Sube tu PDF escaneado.
Elige el motor de OCR que mejor se adapte a tu archivo. Usa Convertir si el texto del PDF ya es seleccionable.
Elige el idioma de tu PDF para obtener mejores resultados (opcional).
Inicia la conversión y espera hasta que tu descarga esté lista.
Sí. Convertir un PDF escaneado a texto es gratis y no requiere cuenta. Sube el archivo, elige un motor y descarga el resultado. Los archivos de hasta 100 MB están cubiertos por el límite gratuito y un plan solo es relevante para archivos más grandes y lotes más largos.
Sí. El OCR estándar es el motor gratuito y procesa escaneos normales sin registro. Los 3 motores avanzados con IA son la mejora para páginas que el motor estándar no puede leer, como copias tenues o fotos tomadas con poca luz.
Porque el archivo contiene imágenes de páginas en lugar de caracteres. Un escáner fotografía el papel, de modo que cada palabra es un patrón de píxeles. El reconocimiento óptico de caracteres lee esos píxeles y escribe caracteres reales, que es lo que vuelve el texto seleccionable, buscable y editable.
Sube el PDF arriba, elige un motor de OCR e inicia la conversión. El resultado es un archivo de texto sin formato que puedes abrir en cualquier editor y copiar desde ahí. Copiar directamente desde un lector de PDF solo funciona cuando el archivo ya tiene una capa de texto.
Reconoce 124 idiomas de origen, incluido chino tanto en forma simplificada como tradicional con diseños verticales, y las variantes cirílicas de azerbaiyano, serbio y uzbeko. Selecciona todos los idiomas que aparezcan en el archivo, porque una página mixta se lee mejor cuando están todos incluidos.
No desde esta página, que crea un archivo de texto sin formato. Conserva las palabras y descarta el diseño. Para obtener un DOC o DOCX con formato, usa la aplicación Convertir a Word, que ejecuta el mismo reconocimiento de texto y crea un documento de Word.
La calidad del reconocimiento depende de la calidad del escaneo. Una página torcida, una resolución baja, una sombra sobre el papel o una foto tomada a mano reducen la precisión. Prueba IA-OCR avanzada para escaneos imperfectos e IA-OCR+ avanzada para poca iluminación, y vuelve a escanear a 300 dpi cuando sea posible. Un archivo de origen protegido con contraseña o dañado no se convertirá.
Sí. Las subidas y descargas se realizan mediante una conexión cifrada, el procesamiento tiene lugar dentro de la Unión Europea y todo el proceso está automatizado, por lo que nadie lee tus escaneos. Tus archivos nunca se usan para entrenar modelos de IA y conservas los derechos sobre ellos.
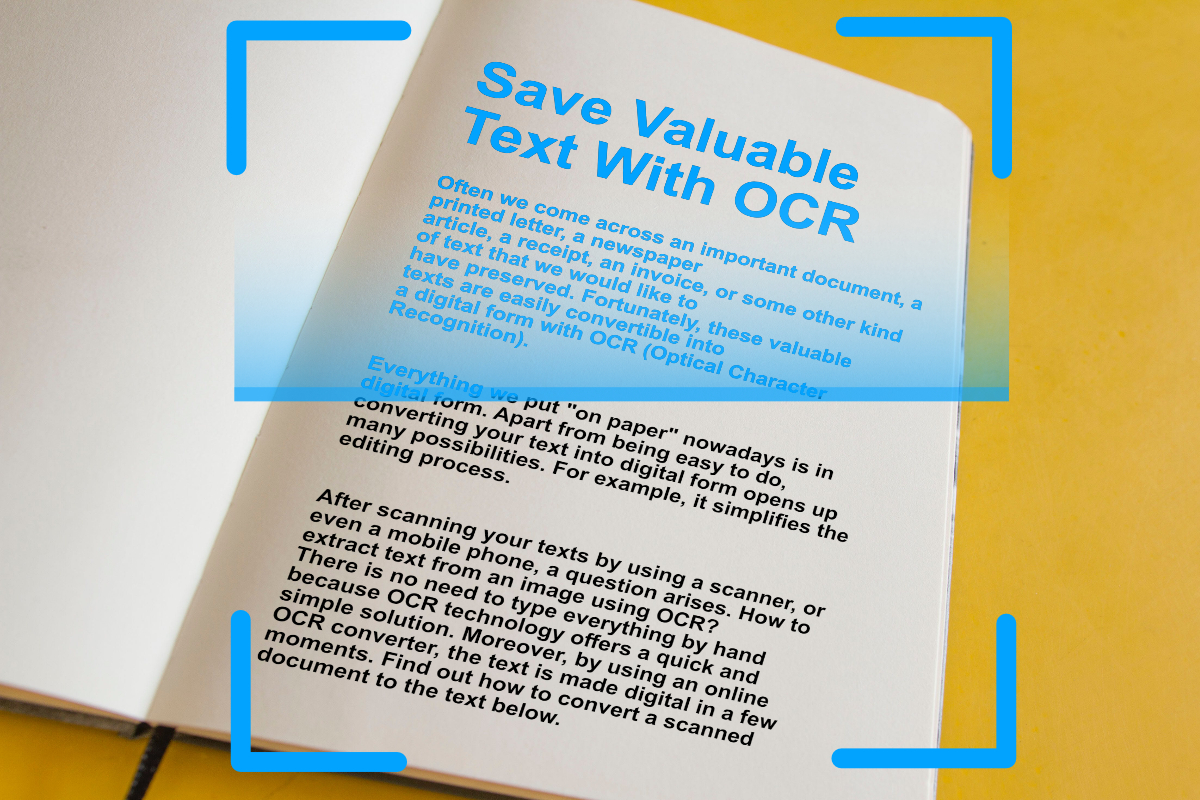
Digitaliza textos valiosos de documentos escaneados e imágenes con OCR (Reconocimiento Óptico de Caracteres). Extrae texto de imágenes fácilmente, en línea.
Leer artículoTodas estas herramientas se ejecutan en el navegador. Sin instalación, sin cuenta y con el mismo reconocimiento de texto detrás.
