Convierte PDF a texto en tu navegador y descarga un archivo TXT sin formato. El reconocimiento de texto está disponible cuando lo necesitas y desactivado cuando no.
o arrastra, pega o elige desde la nube


Convertir un PDF a texto puede significar dos tareas distintas, y este conversor te deja elegir la que necesitas. La mayoría de los PDF ya contienen caracteres reales, así que solo hay que leer el texto. Un PDF escaneado contiene en cambio imágenes de páginas, y esos caracteres deben reconocerse antes de poder extraerlos.
El reconocimiento de texto está desactivado de forma predeterminada, y es intencional. Un PDF con una capa de texto real se convierte más rápido y con mayor precisión sin OCR, porque las palabras se copian en lugar de deducirse desde una imagen. Activar el reconocimiento cuando el archivo no lo necesita solo puede restar precisión.
Puedes saber qué tipo de archivo tienes en un segundo. Abre el PDF en cualquier visor y arrastra sobre una línea. Si las palabras se resaltan, deja el OCR desactivado. Si no se resalta nada, actívalo y elige tu documento entre los 124 idiomas de origen que admite el reconocimiento.
Extraer el texto de un PDF convierte una página que solo puedes mirar en palabras que puedes usar. El conversor escribe todo lo que encuentra en un archivo de texto plano, para que puedas copiar una cita, pegar un párrafo en un correo o buscar en todo el documento con el comando de buscar en cualquier editor.
Eso cubre las tareas que la gente suele tener en mente: extraer referencias de un artículo, sacar cifras de un informe o pasar el cuerpo de un documento largo a una herramienta de escritura. Nada se vuelve a teclear y nada se transcribe a mano.
Puedes subir varios PDF a la vez. Cada archivo se convierte por separado y se devuelve como su propio archivo de texto, con el mismo ajuste de OCR y el mismo idioma aplicado a todos. No necesitas una cuenta ni se pide una dirección de correo.
La extensión de archivo .txt se usa para archivos de texto sin formato. Estos archivos contienen líneas de texto y se pueden abrir en muchos editores de texto en diferentes plataformas y dispositivos. El texto no contiene ningún formato.
Ese es el motivo de pasar de PDF a TXT en lugar de a un formato de documento. El archivo se abre en cualquier ordenador y en cualquier teléfono, no requiere licencia de lectura y sigue siendo legible mucho después de que el programa que produjo el original haya sido sustituido.
Extensión de archivo: .txt, tipo MIME: text/plain
TXT en WikipediaUn archivo de texto plano contiene palabras, no páginas. Esto es lo que se mantiene en la conversión y lo que no.
| Del PDF | En el archivo TXT |
|---|---|
| Palabras y saltos de línea | Se mantiene |
| Orden de lectura | Se mantiene, de arriba abajo |
| Negritas, cursivas y fuentes | Se pierde |
| Imágenes, logotipos y gráficos | Se pierde |
| Tablas | Se mantiene como texto, sin la cuadrícula |
| Páginas de varias columnas | Se vuelcan en una sola columna |
| Encabezados, pies de página y números de página | Se escriben junto con el texto |
Un archivo de texto plano conserva las palabras, no el diseño. Cuando el formato importa tanto como las palabras, la app de PDF a Word es la opción más adecuada.
Las palabras de un PDF están bloqueadas en un diseño de página. Estos son los casos en los que extraerlas en texto plano ahorra más trabajo.
Artículos, informes y libros se comparten como PDF. Extrae el texto una vez y pega los pasajes que necesitas en tus notas en lugar de volver a escribirlos.
Un archivo de texto se abre en cualquier editor, así que puedes ir directo a un nombre, una fecha o una cantidad en lugar de leer página tras página.
Traductores, herramientas de escritura, lectores de pantalla y hojas de cálculo aceptan texto plano. TXT es el formato que casi todas admiten sin conversor.
Los PDFs que la gente convierte suelen ser contratos, facturas o correspondencia privada. Aquí tienes exactamente cómo se tratan los tuyos.
Todas las subidas y descargas usan una conexión cifrada, por lo que tus archivos no pueden leerse durante la transmisión.
Stored on servers with full-disk encryption, and backups are encrypted too.
El reconocimiento de texto está completamente automatizado. Nadie lee tus escaneos o documentos, y nada se comparte con terceros.
Sube tu PDF.
Activa el OCR si el PDF es un escaneo. Déjalo desactivado cuando el texto del archivo ya sea seleccionable.
Selecciona el idioma de tu documento en el menú (opcional).
Haz clic en "Start" y espera a que termine la conversión.
Sí. Convertir un PDF a texto es gratis y no requiere cuenta, y no se pide ninguna dirección de correo. Sube el archivo, inicia la conversión y descarga el texto. Un plan solo es relevante para archivos muy grandes y lotes más largos.
Sube el PDF arriba, deja el OCR desactivado si el texto del archivo ya es seleccionable y empieza la conversión. El resultado es un archivo de texto plano que puedes descargar y abrir en cualquier editor. No hay que instalar nada.
Si las palabras se resaltan cuando arrastras sobre ellas, puedes copiarlas directamente desde tu visor de PDF. Si no se resaltan, la página es una imagen y no hay nada que seleccionar. Convertir el PDF a texto resuelve eso, porque la salida es un archivo de texto del que puedes copiar libremente.
Eso es exactamente lo que genera este conversor. TXT es el formato de texto plano, así que el archivo que descargas lleva la extensión .txt y el tipo de medio text/plain. Se abre en el Bloc de notas, TextEdit, cualquier editor de código y cualquier teléfono, sin software adicional.
Porque la mayoría de los PDF no lo necesitan. Un PDF con una capa de texto real se convierte más rápido y con mayor precisión cuando las palabras se copian en lugar de reconocerse desde una imagen. Activa el OCR solo cuando las páginas sean escaneos o fotografías, y con él aparecerá el selector de idioma.
Sí, con el OCR activado. El reconocimiento lee los caracteres de las imágenes de las páginas y los escribe en el archivo de texto. Si la mayoría de lo que conviertes son escaneos, la app de PDF escaneado a texto es la ruta más directa al mismo resultado.
Reconoce 124 idiomas de origen. Además de los europeos, la lista incluye hindi, bengalí, tamil, urdu, árabe, tailandés, japonés, coreano y chino tanto en forma simplificada como tradicional. Elige el idioma en el que está escrito tu documento para obtener el mejor resultado.
Sí. Añade todos los PDF que necesites y se convertirán en un solo proceso, cada uno como su propio archivo de texto con la misma configuración de OCR y el mismo idioma aplicados.
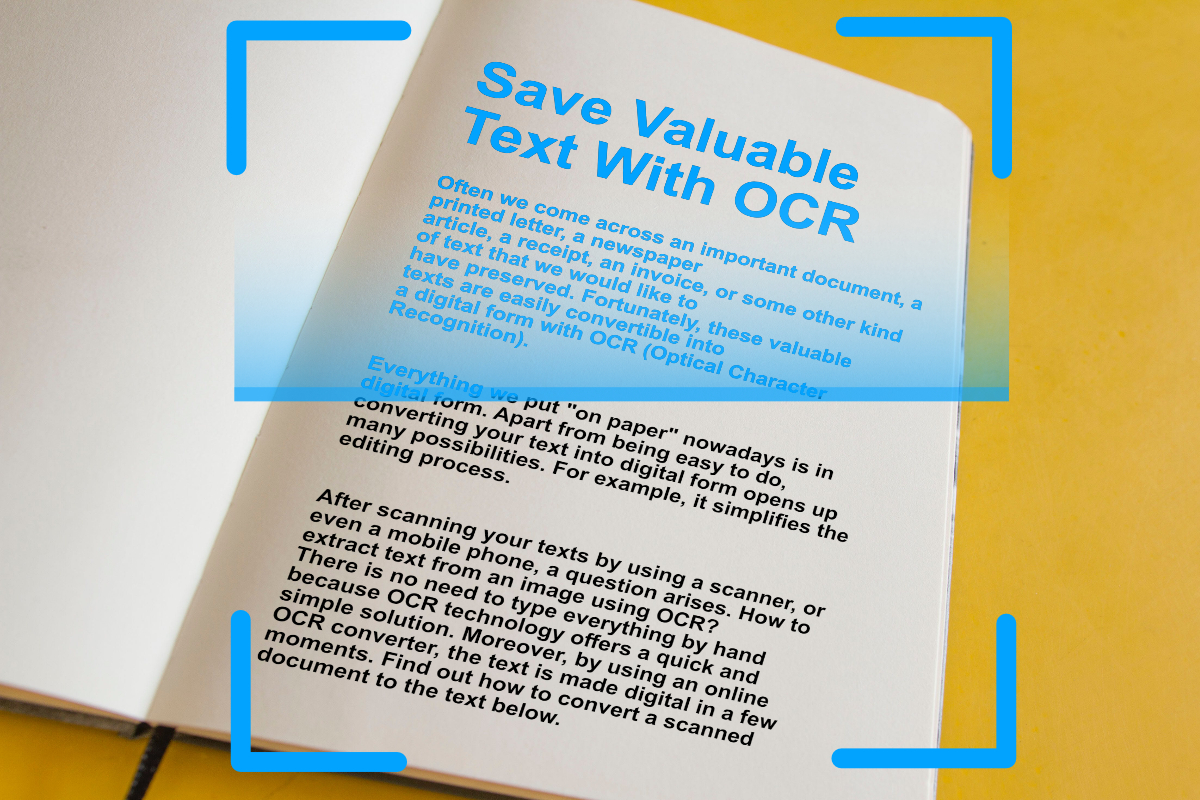
Digitaliza textos valiosos de documentos escaneados e imágenes con OCR (Reconocimiento Óptico de Caracteres). Extrae texto de imágenes fácilmente, en línea.
Leer artículoTodas estas herramientas se ejecutan en el navegador. Sin instalación, sin cuenta y con el mismo reconocimiento de texto detrás.
