Extrayez le texte de documents numérisés ou photographiés.
ou déposez, collez ou choisissez depuis le cloud


Convertir un document numérisé en texte revient à une chose : récupérer les mots d’une page qui n’est qu’une image. Un scanner ou l’appareil photo d’un téléphone enregistre le papier comme une image plate, donc les lettres sont des pixels et non des caractères. Rien dans ce fichier ne peut être sélectionné, recherché ou corrigé tant que la page n’a pas été lue et réécrite en texte.
Qu'est-ce que l'OCR ? La reconnaissance optique de caractères permet d'identifier des lettres, des chiffres ou des caractères spéciaux dans un document ou une image numérisé(e). Avec un convertisseur OCR, vous pouvez extraire le texte de ces fichiers afin de le modifier, l'imprimer ou l'enregistrer.
Ce que vous récupérez est un fichier texte brut. Il contient les mots et les retours à la ligne du document, pas la mise en page. Pour la plupart des tâches, c’est exactement l’objectif : vous aviez besoin du texte de la lettre, des chiffres du formulaire ou du paragraphe auquel vous devez répondre.
La conversion d’un document numérisé en texte peut traiter plusieurs fichiers à la fois. Ajoutez chaque page d’un rapport, ou un dossier de lettres numérisées, et chaque fichier est converti séparément et revient comme son propre fichier texte. Sans compte, vous pouvez envoyer 10 scans en un seul envoi.
Un seul réglage décide de la qualité de la reconnaissance : la langue du document. L’anglais est déjà sélectionné, donc une page en anglais ne demande aucun changement. Pour tout autre cas, choisissez la langue correspondante dans la liste de 124 avant de commencer.
Les photos de documents comptent ici comme des scans. Ouvrez cette page sur un téléphone, envoyez la photo depuis la galerie et la même reconnaissance s’applique. Si le téléphone a enregistré la page en PDF au lieu d’une image, l’application conçue pour les scans PDF est plus adaptée.
Convertir un PDF numérisé en texteL'extension de fichier .txt est utilisée pour les fichiers texte simples. Ces fichiers contiennent des lignes de texte et peuvent être ouverts dans de nombreux éditeurs de texte sur différentes plates-formes et appareils. Le texte ne contient aucun formatage.
Pour un document qui a commencé sur papier, le texte brut est le format final le plus facile à utiliser. Le fichier est très léger, il s’ouvre sur n’importe quel ordinateur ou téléphone sans licence, et les mots se collent dans un e-mail, un formulaire ou un outil de traduction sans emporter la mise en forme de la page d’origine.
Extension de fichier : .txt, type MIME : text/plain
TXT sur WikipediaLa reconnaissance de texte ne peut lire que ce que le scan lui montre. Voici comment se comportent les documents que les utilisateurs envoient le plus souvent.
| Le document | Comment il a été capturé | Résultat obtenu |
|---|---|---|
| Une page imprimée à 300 dpi | Un scanner de bureau ou une imprimante multifonction | Très propre. C’est le type de document le plus simple à lire. |
| Un rapport de plusieurs pages | Un scan par page, envoyés ensemble | Chaque page revient comme son propre fichier texte, dans l’ordre où vous les avez ajoutées. |
| Une photo de document | Un téléphone tenu au-dessus de la feuille | Bon résultat, tant que la page est plate, remplit le cadre et ne porte pas d’ombre. |
| Un formulaire ou un tableau | N’importe quel scanner ou appareil photo | Les mots ressortent, pas les colonnes. Le texte brut n’a pas de structure de tableau. |
| Une page pâle, penchée ou manuscrite | Une vieille copie, un passage de travers ou un stylo | Peu fiable. Cette application ne redresse pas une page, et l’écriture manuscrite ne fait pas partie de ce pour quoi la reconnaissance est conçue. |
Un document numérisé qui se lit mal est presque toujours un problème de capture. Numériser à nouveau la même page, bien à plat et à 300 dpi, améliore les résultats bien plus que n’importe quel réglage de cette page.
Voici les tâches les plus fréquentes pour ce convertisseur.
Quelqu’un vous a envoyé un scan et vous avez besoin du texte, pas de son image. Convertissez le document numérisé en texte et les paragraphes sont prêts à être collés dans une réponse, un formulaire ou un rapport.
La reconnaissance couvre 124 langues de document, donc un scan en indonésien, arabe, hindi ou japonais revient sous forme de texte que vous pouvez coller directement dans un traducteur ou une zone de recherche.
Numérisez la pile, envoyez les images ensemble et chaque document revient comme son propre fichier texte. Rien n’est installé et aucun compte n’est nécessaire.
Chaque envoi et chaque téléchargement passe par une connexion chiffrée, afin que le document ne puisse pas être lu en route vers le convertisseur ni au retour. Le lien vers votre fichier texte final est généré au hasard et ne peut pas être deviné.
La reconnaissance de texte ici est entièrement automatisée. Personne ne lit, n’ouvre ni ne copie les documents que vous envoyez, rien n’est surveillé et vos fichiers ne servent jamais à entraîner des modèles d’IA.
La conversion s’exécute sur des serveurs situés en Europe, exploités dans le cadre d’un accord de traitement des données. Seules votre adresse IP et la date et l’heure sont traitées en plus du fichier, et uniquement pour prévenir les abus du service.
Vous conservez le droit d'auteur et la propriété du document numérisé et du fichier texte généré. Convertir un fichier ici ne cède rien à qui que ce soit.
Importez votre document scanné.
Sélectionnez la langue du document scanné dans le menu déroulant (facultatif).
Cliquez sur "Démarrer" puis, après un court instant, téléchargez votre fichier texte converti.
Oui. La conversion d'un document numérisé en texte est gratuite dans tous les abonnements, ne nécessite pas de compte et ne coûte aucun crédit. Téléversez le scan, cliquez sur Démarrer et téléchargez le fichier texte. Un abonnement payant augmente seulement la taille de fichier et les limites de traitement par lots.
Téléversez le document numérisé ci-dessus, choisissez la langue dans laquelle il est écrit, puis cliquez sur Démarrer. Le convertisseur lit la page et renvoie un fichier texte brut que vous pouvez ouvrir, chercher et modifier dans n'importe quel éditeur. Il n'y a rien à installer.
Oui. Ajoutez 10 scans en un seul téléversement sans compte, et chaque document est converti séparément et renvoyé sous la forme de son propre fichier texte. La langue que vous choisissez s'applique à tous.
Un PDF numérisé est mieux géré par l'application PDF numérisé vers texte. Elle est conçue pour les pages PDF et vous permet de choisir le moteur de reconnaissance, ce qui fait une différence pour un long document. Pour le reste, elle fonctionne de la même façon.
124 langues de documents, de l'anglais, l'indonésien et l'espagnol à l'arabe, l'hindi, le japonais et le coréen. Choisissez celle qui correspond aux mots sur la page. L'anglais est présélectionné, un document en anglais ne nécessite donc aucun changement.
Non, et c'est justement l'objectif d'un fichier texte. Les mots et les retours à la ligne sont conservés ; les colonnes, tableaux, en-têtes et numéros de page ne le sont pas, car le texte brut n'a pas de pages. Utilisez l'application de conversion en Word si vous avez besoin de récupérer la mise en page.
Vérifiez deux choses. D'abord, que la langue sélectionnée correspond au document. Ensuite, le scan lui-même : une page pâle, inclinée ou en basse résolution perd des caractères, et cette application ne redresse ni ne nettoie la page pour vous. Un nouveau scan à 300 dpi corrige la plupart des problèmes.
Oui. Ils transitent via une connexion chiffrée et sont traités automatiquement sur des serveurs situés dans l'Union européenne. Personne ne les lit ni ne les copie, ils ne servent jamais à entraîner des modèles d'IA, et le lien de téléchargement est aléatoire, il ne peut donc pas être deviné.
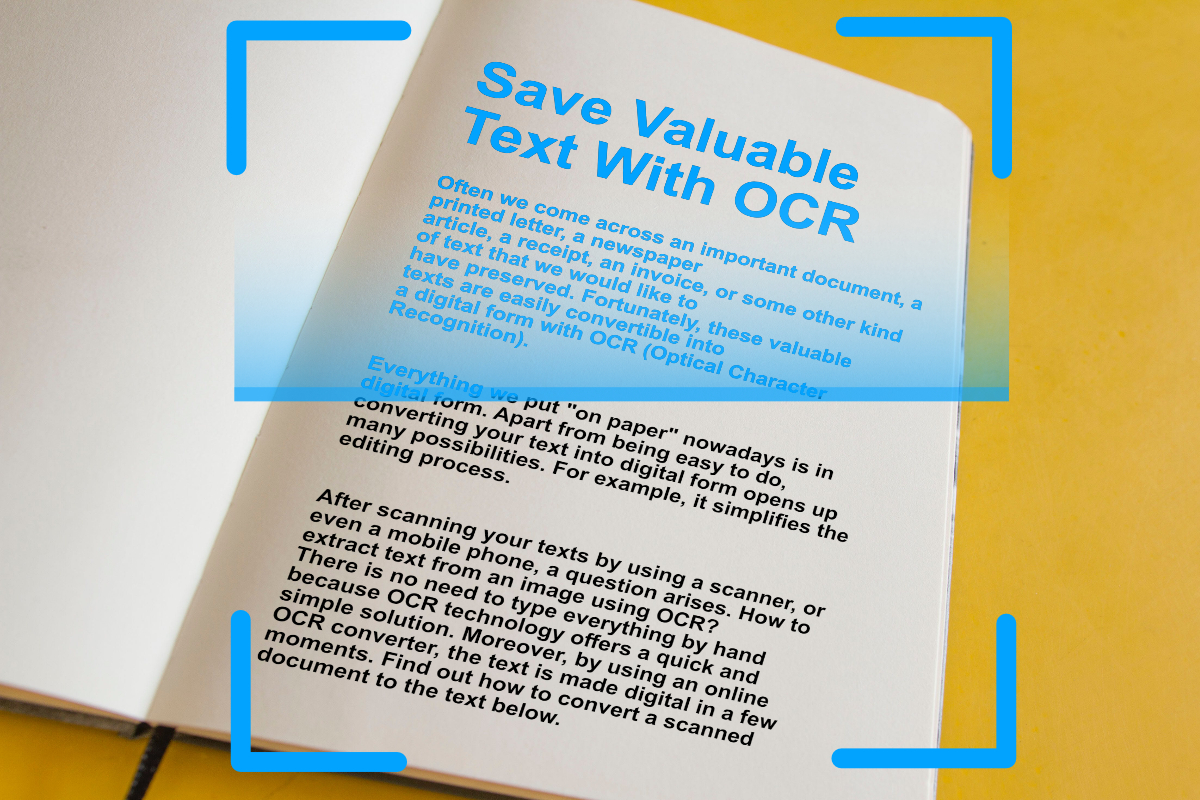
Numérisez des textes importants à partir de documents et d'images scannés grâce à l'OCR (reconnaissance optique de caractères). Extrayez facilement du texte à partir d'images, en ligne.
Lire l'articleChacun de ces outils s'exécute dans le navigateur, avec la même reconnaissance de texte en arrière-plan et rien à installer.
