Ekstrak teks dari dokumen hasil pemindaian atau foto.
atau jatuhkan, tempel, atau pilih dari cloud


Dokumen hasil scan ke teks berarti satu hal: mengambil kata-kata dari halaman yang hanya berupa gambar. Scanner atau kamera ponsel merekam kertas sebagai gambar datar, jadi huruf di dalamnya adalah piksel, bukan karakter. Tidak ada yang bisa dipilih, dicari, atau dikoreksi dalam file itu sampai halaman dibaca dan dituliskan sebagai teks.
Apa itu OCR? Optical character recognition digunakan untuk mengidentifikasi huruf, angka, atau karakter khusus dalam dokumen hasil pemindaian atau gambar. Dengan konverter OCR, Anda dapat mengekstrak teks dari file tersebut untuk mengubah, mengedit, mencetak, atau menyimpannya.
Hasilnya adalah file teks biasa. Isinya kata-kata dan jeda baris dari dokumen, bukan desain halamannya. Untuk sebagian besar pekerjaan, itulah tujuannya: Anda hanya membutuhkan isi surat, angka di formulir, atau paragraf yang harus Anda jawab.
Konversi dokumen hasil scan ke teks dapat dijalankan pada lebih dari satu file sekaligus. Tambahkan setiap halaman laporan, atau satu folder surat hasil scan, dan setiap file akan dikonversi sendiri-sendiri dan dikembalikan sebagai file teks masing-masing. Tanpa akun, Anda bisa mengirim 10 scan dalam satu unggahan.
Satu pengaturan yang menentukan seberapa baik pengenalan teks bekerja, yaitu bahasa dokumen. Bahasa Inggris sudah terpilih, jadi halaman berbahasa Inggris tidak perlu diubah sama sekali. Untuk bahasa lain, pilih bahasa yang sesuai dari daftar 124 sebelum memulai.
Foto kertas juga dihitung sebagai scan di sini. Buka halaman ini di ponsel, unggah foto dari galeri kamera dan pengenalan yang sama akan dijalankan. Jika ponsel menyimpan halaman sebagai PDF, bukan gambar, aplikasi yang dibuat untuk scan PDF adalah pilihan yang lebih tepat.
Konversi PDF hasil pemindaian ke teksEkstensi file .txt digunakan untuk file teks biasa. File ini berisi teks dalam beberapa baris dan dapat dibuka di berbagai editor teks di berbagai platform dan perangkat. Teksnya tidak mengandung format apa pun.
Untuk dokumen yang asalnya dari kertas, teks biasa adalah hasil yang paling mudah digunakan. Filenya sangat kecil, bisa dibuka di komputer atau ponsel apa pun tanpa lisensi, dan kata-katanya bisa ditempel ke email, formulir, atau alat terjemahan tanpa membawa tampilan halaman aslinya.
Ekstensi file: .txt, tipe MIME: text/plain
TXT di WikipediaPengenalan teks hanya bisa membaca apa yang ditampilkan oleh hasil scan. Berikut cara hasil dokumen yang paling sering diunggah pengguna.
| Dokumennya | Cara pengambilan gambarnya | Hasil keluarannya |
|---|---|---|
| Halaman tercetak pada 300 dpi | Scanner kantor atau printer multifungsi | Sangat bersih. Ini jenis dokumen yang paling mudah dibaca. |
| Laporan dengan banyak halaman | Satu scan per halaman, diunggah bersamaan | Setiap halaman kembali sebagai file teks sendiri, dalam urutan saat Anda menambahkannya. |
| Foto dokumen | Kamera ponsel yang diarahkan di atas kertas | Hasilnya baik, selama halaman rata, memenuhi bingkai, dan tidak ada bayangan. |
| Formulir atau tabel | Scanner atau kamera apa saja | Kata-katanya keluar, kolomnya tidak. Teks biasa tidak memiliki struktur tabel. |
| Halaman yang pudar, miring, atau tulisan tangan | Salinan lama, hasil scan miring, atau tulisan pena | Tidak andal. Aplikasi ini tidak meluruskan halaman, dan tulisan tangan bukan yang ditujukan untuk pengenalan ini. |
Dokumen hasil scan yang sulit dibaca hampir selalu bermasalah pada saat pengambilan gambarnya. Menscan ulang halaman yang sama, rata dan pada 300 dpi, memperbaiki lebih banyak hasil daripada pengaturan apa pun di halaman ini.
Ini tugas yang paling sering dibawa pengguna ke converter ini.
Seseorang mengirimkan scan dan Anda hanya butuh isi teksnya, bukan gambarnya. Konversi dokumen hasil scan ke teks dan paragrafnya siap ditempel ke balasan, formulir, atau laporan.
Pengenalan teks mencakup 124 bahasa dokumen, jadi scan dalam bahasa Indonesia, Arab, Hindi, atau Jepang akan kembali sebagai teks yang bisa langsung Anda tempel ke penerjemah atau kotak pencarian.
Scan tumpukan tersebut, unggah gambarnya bersama-sama dan setiap dokumen akan kembali sebagai file teks masing-masing. Tidak ada yang diinstal dan tidak perlu akun untuk melakukannya.
Setiap unggahan dan setiap unduhan berjalan melalui koneksi terenkripsi, jadi dokumen tidak bisa dibaca saat dikirim ke converter atau saat dikirim kembali. Tautan ke file teks yang sudah jadi dibuat secara acak dan tidak bisa ditebak.
Pengenalan teks di sini sepenuhnya otomatis. Tidak ada yang membaca, membuka, atau menyalin dokumen yang Anda kirim, tidak ada yang dipantau, dan file Anda tidak pernah digunakan untuk melatih model AI.
Konversi dijalankan pada server yang berlokasi di Eropa, dioperasikan berdasarkan perjanjian pemrosesan data. Hanya alamat IP serta tanggal dan waktu yang diproses bersama file, dan hanya untuk mencegah penyalahgunaan layanan.
Anda tetap memegang hak cipta dan kepemilikan dokumen hasil scan dan file teks yang dihasilkan. Mengonversi file di sini tidak menyerahkan apa pun kepada siapa pun.
Unggah dokumen hasil pemindaian Anda.
Pilih bahasa dokumen hasil pemindaian dari menu dropdown (opsional).
Klik "Mulai" dan setelah menunggu sebentar, unduh file teks yang sudah dikonversi.
Ya. Mengonversi dokumen hasil scan ke teks gratis di semua paket, tidak perlu akun dan tidak menghabiskan kredit. Unggah hasil scan, klik Mulai dan unduh file teksnya. Paket berbayar hanya menaikkan batas ukuran file dan pemrosesan batch.
Unggah dokumen hasil scan di atas, pilih bahasa yang digunakan di dalamnya, lalu klik Mulai. Konverter akan membaca halaman dan menghasilkan file teks biasa yang bisa Anda buka, cari, dan edit di editor apa pun. Tidak ada yang perlu diinstal.
Bisa. Tambahkan 10 hasil scan dalam satu unggahan tanpa akun, dan setiap dokumen akan dikonversi sendiri-sendiri dan dikembalikan sebagai file teks terpisah. Bahasa yang Anda pilih akan digunakan untuk semuanya.
Scan PDF lebih baik diproses dengan aplikasi scanned PDF to text. Aplikasi itu dibuat khusus untuk halaman PDF dan memungkinkan Anda memilih mesin pengenalan, yang berpengaruh untuk dokumen yang panjang. Selebihnya cara kerjanya sama.
124 bahasa dokumen, dari bahasa Inggris, Indonesia, dan Spanyol hingga Arab, Hindi, Jepang, dan Korea. Pilih yang sesuai dengan teks pada halaman. Bahasa Inggris sudah dipilih otomatis, jadi dokumen berbahasa Inggris tidak perlu diubah.
Tidak, dan itulah fungsi file teks. Kata-kata dan jeda baris akan ikut, tetapi kolom, tabel, header, dan nomor halaman tidak, karena teks biasa tidak memiliki halaman. Gunakan aplikasi convert to Word jika Anda perlu mengembalikan tata letak.
Periksa dua hal. Pertama, bahwa bahasa yang dipilih sesuai dengan dokumennya. Kedua, hasil scannya sendiri: halaman yang samar, miring, atau beresolusi rendah akan membuat karakter hilang, dan aplikasi ini tidak akan meluruskan atau membersihkan halaman untuk Anda. Memindai ulang pada 300 dpi biasanya memperbaiki sebagian besar masalah.
Ya. Dokumen dikirim melalui koneksi terenkripsi dan diproses otomatis di server di Uni Eropa. Tidak ada yang membaca atau menyalinnya, dokumen tidak pernah digunakan untuk melatih model AI, dan tautan unduhannya acak sehingga tidak bisa ditebak.
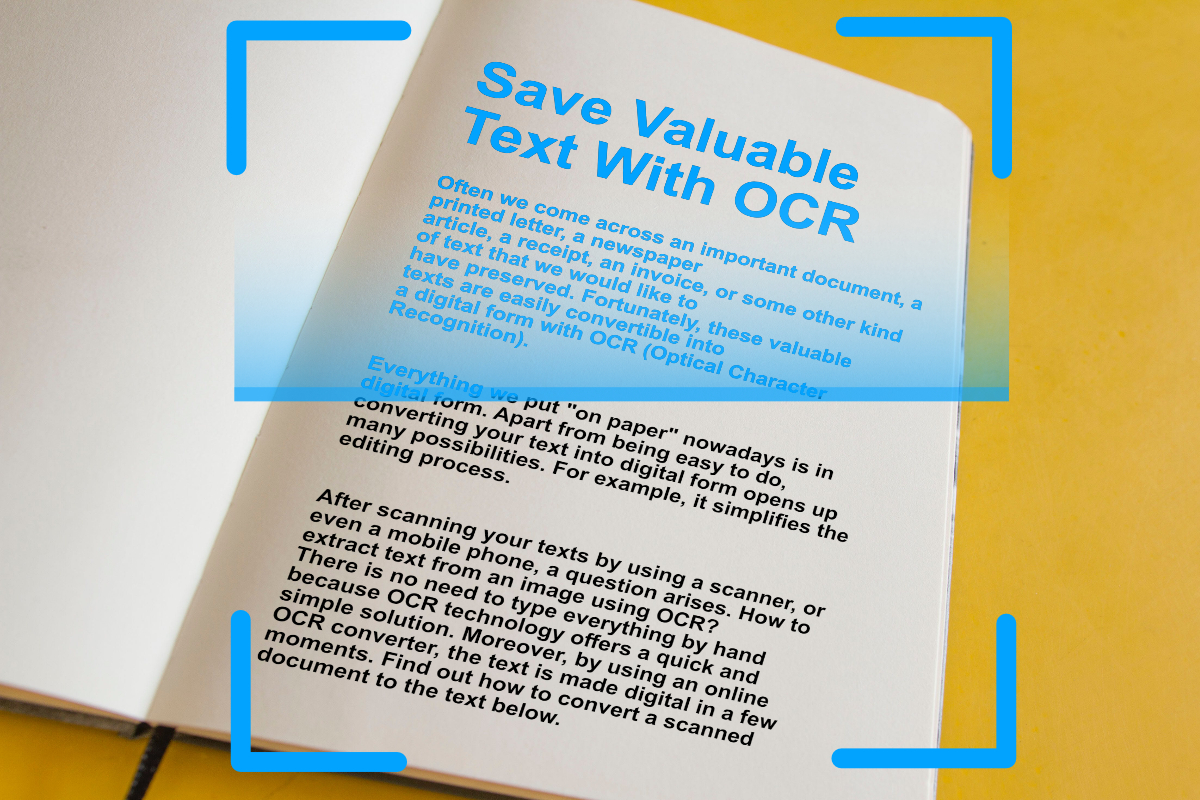
Digitalisasi teks berharga dari dokumen hasil pemindaian dan gambar dengan OCR (Optical Character Recognition). Ekstrak teks dari gambar dengan mudah, secara online.
Baca artikelSemua ini berjalan di browser, dengan pengenalan teks yang sama di belakangnya dan tanpa instalasi apa pun.
