解决方案
在浏览器中将 PDF 转换为文本并下载纯 TXT 文件。需要时可启用文本识别,不需要时可关闭。
或拖放、粘贴,或从云端选择
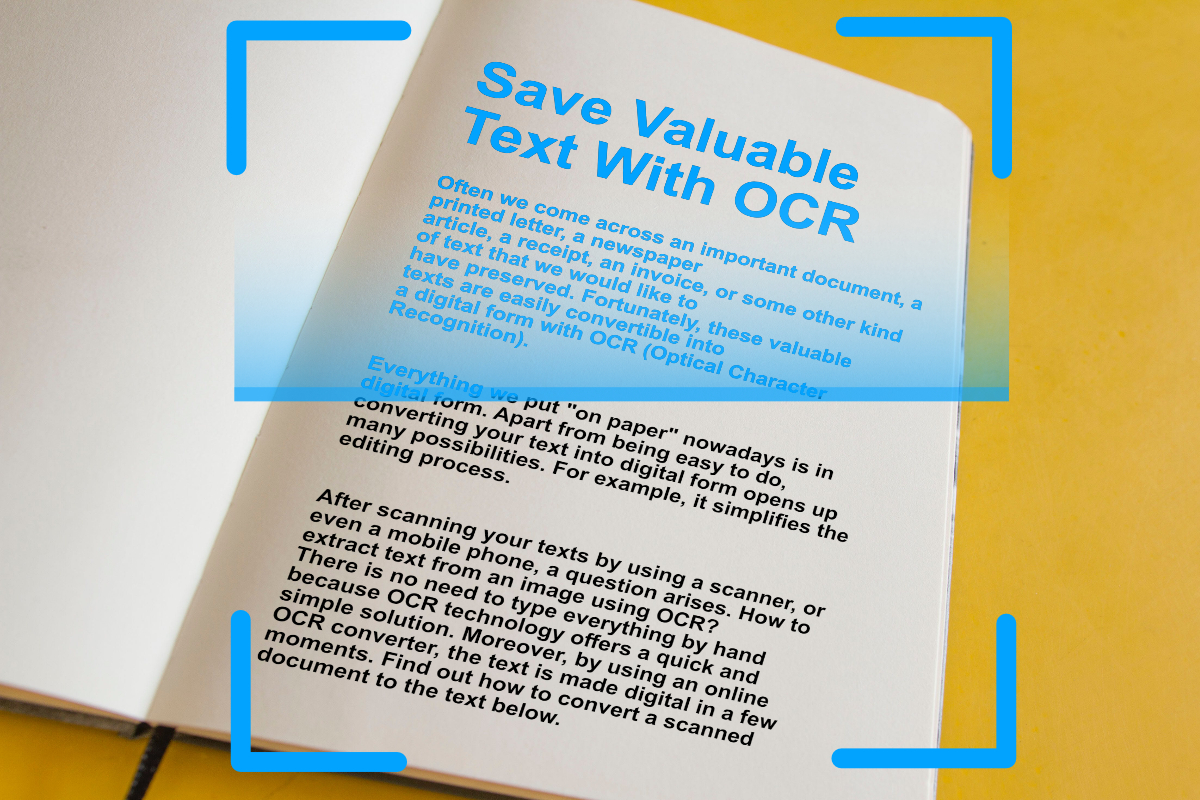
将 PDF 转换为文本可能指两种不同的工作,而这个转换器让你自行选择所需方式。大多数 PDF 已经包含真实字符,因此只需读取文本即可。扫描版 PDF 则只包含页面图片,必须先识别其中的字符,才能提取任何内容。
文字识别默认是关闭的,这是刻意设计的。对带有真实文本层的 PDF 来说,不启用识别可以更快、更准确地转换,因为文字是复制而非从图像中推断。如果文件不需要识别却开启了 OCR,只会降低准确度。
你可以在一秒内判断自己手上的是哪种文件。在任意阅读器中打开 PDF,并拖动选择一行文字。如果文字会被高亮,保持 OCR 开关关闭即可。如果无法高亮,说明页面是图片,请开启 OCR,并从识别支持的 124 种源语言中选择你的文档语言。
从 PDF 中提取文本,可以把只能查看的页面变成可使用的文字。转换器会将找到的一切写入纯文本文件,你可以复制引用、将一段文字粘贴到邮件中,或在任意编辑器里用查找命令搜索整份文档。
这涵盖了人们通常的需求:从论文中提取参考内容,从报告中取出数据,或将长文档的正文转入写作工具。无需重新输入,也无需人工转录。
你可以一次上传多个 PDF。每个文件会单独转换,并各自生成一个文本文件,对所有文件使用相同的 OCR 设置和语言。无需账号,也不会索取电子邮件地址。
.txt 文件扩展名用于纯文本文件。这些文件由多行文本组成,可在不同平台和设备上的各种文本编辑器中打开,文本本身不包含任何格式。
这正是选择从 PDF 转为 TXT 而不是文档格式的原因。TXT 文件能在任何电脑和手机上打开,无需阅读授权,并能在生成原文件的程序被替换很久以后依然保持可读。
文件扩展名:.txt,MIME 类型:text/plain
维基百科上的 TXT纯文本文件保存的是文字,而不是页面。以下是转换后保留和不保留的内容。
| 在 PDF 中 | 在 TXT 文件中 |
|---|---|
| 文字和换行 | 保留 |
| 阅读顺序 | 从上到下保留 |
| 粗体、斜体和字体 | 丢弃 |
| 图片、标志和图表 | 丢弃 |
| 表格 | 以文本形式保留,不带表格线 |
| 多栏页面 | 合并为单栏 |
| 页眉、页脚和页码 | 与正文一起写入文本 |
纯文本文件承载的是文字而非版式。当排版与文字同样重要时,PDF 转 Word 工具更合适。
PDF 中的文字被锁定在页面版式中。以下这些情况,直接提取为纯文本可大幅减少工作量。
论文、报告和书籍通常以 PDF 形式共享。将文本提取一次即可,把需要的段落粘贴到笔记中,而不是重新敲一遍。
文本文件可在任何编辑器中打开,你可以直接跳转到某个名字、日期或金额,而不必一页页往下读。
翻译工具、写作工具、屏幕阅读器和电子表格都可直接处理纯文本。TXT 是几乎所有这类工具都能直接接受的格式,无需额外转换。
用户转换的 PDF 通常是合同、发票或私人通信。以下是我们处理这些文件的具体方式。
所有上传和下载都通过加密连接进行,传输中的文件无法被读取。
Stored on servers with full-disk encryption, and backups are encrypted too.
文字识别完全自动化。不会有人阅读你的扫描件或文档,也不会与第三方共享任何内容。
上传你的 PDF。
如果 PDF 是扫描件,请开启 OCR。如果文件中的文字已经可以选择,则保持关闭。
在菜单中选择文档语言(可选)。
点击"开始"并等待转换完成。
是的。将 PDF 转换为文本是免费的,无需账号,也不会索取电子邮件地址。上传文件、开始转换并下载文本即可。只有在处理超大文件或超长批量任务时,套餐才会起作用。
在上方上传 PDF,如果文件中的文字已经可以选择,请保持 OCR 开关关闭,然后开始转换。结果会是一个可下载的纯文本文件,可在任意编辑器中打开,无需安装任何软件。
如果拖动鼠标时文字会被高亮,你就可以直接在 PDF 阅读器中复制。如果不会,说明页面是图片,无法选择任何内容。先将 PDF 转换为文本即可解决,因为输出的是可自由复制的文本文件。
这正是本转换器生成的格式。TXT 是纯文本格式,因此你下载的文件扩展名为 .txt,媒体类型为 text/plain。它可以在记事本、TextEdit、任意代码编辑器以及任何手机上打开,无需额外软件。
因为大多数 PDF 并不需要它。对带有真实文本层的 PDF 来说,直接复制文字而不是从图像中识别,可以更快、更准确地转换。只有当页面是扫描件或照片时才开启 OCR,并会随之显示语言选择器。
可以,在开启 OCR 的情况下。识别功能会从页面图像中读取字符,并将其写入文本文件。如果你要转换的大多是扫描件,扫描 PDF 转文本工具是通往同一结果的更直接路径。
它支持识别 124 种源语言。除了各种欧洲语言外,还包括印地语、孟加拉语、泰米尔语、乌尔都语、阿拉伯语、泰语、日语、韩语以及简体和繁体中文。请选择与你文档一致的语言,以获得最佳结果。
可以。添加任意数量的 PDF,它们会在一次处理中全部转换,每个文件会分别导出为自己的文本文件,并应用相同的 OCR 设置和语言。
这些功能全部在浏览器中运行。无需安装,无需账户,并使用相同的文本识别技术。