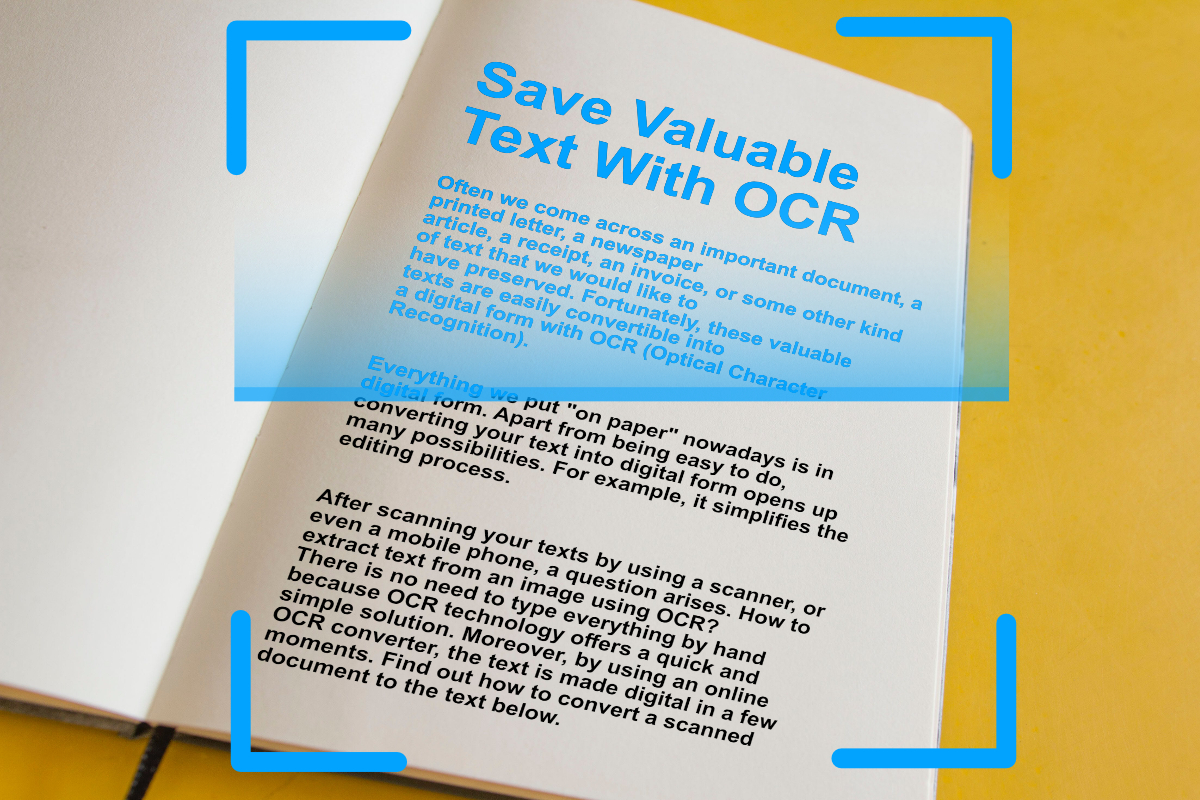
यह JPG से PDF कन्वर्टर OCR चला सकता है, ताकि आपकी इमेज में मौजूद टेक्स्ट चयन योग्य टेक्स्ट बन जाए।
या अपनी फ़ाइल खींचें, पेस्ट करें, या क्लाउड से चुनें


OCR क्या है? स्कैन किए गए दस्तावेज़ या छवि में अक्षर, संख्याएँ या विशेष वर्णों को पहचानने के लिए ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) का उपयोग किया जाता है। OCR कन्वर्टर की मदद से आप ऐसे फ़ाइलों से टेक्स्ट निकाल सकते हैं, ताकि आप उसे बदल, संपादित, प्रिंट या सहेज सकें।
टेक्स्ट रिकग्निशन के बिना PDF में मौजूद JPG अब भी सिर्फ तस्वीर ही रहता है। उसमें से कुछ भी न चुना जा सकता है, न कॉपी किया जा सकता है, न खोजकर पाया जा सकता है। OCR अक्षरों को पढ़ता है और उन्हें PDF में असली टेक्स्ट के रूप में सहेजता है।
टेक्स्ट रिकग्निशन 124 भाषाएं पढ़ सकता है, अंग्रेजी, स्पैनिश और पुर्तगाली से लेकर हिंदी, अरबी, रूसी और जापानी तक। अपने पेज की भाषा सेट करें, और नतीजा साफ तौर पर ज़्यादा सटीक हो जाता है।
एक हाथ में पेज पकड़े और दूसरे से ली गई फोटो कभी भी पूरी तरह सीधी नहीं होती। डेस्क्यू टेढ़े स्कैन या फोटो को अपने आप सीधा करता है, जिससे टेक्स्ट रिकग्निशन का काम काफी आसान हो जाता है।
JPG में पिक्सेल होते हैं, अक्षर नहीं। उसे सीधे PDF में डालें तो पेज दिखने में सही लगता है, लेकिन कंप्यूटर अब भी उसे फोटो ही मानता है: कोई शब्द चुना नहीं जा सकता, कोई उद्धरण कॉपी नहीं किया जा सकता और खोज में कुछ नहीं मिलता।
टेक्स्ट रिकग्निशन यह बदल देता है। यह तस्वीर में मौजूद आकृतियों को पढ़ता है, समझता है कि वे कौन से अक्षर हैं, और उन्हें तस्वीर के साथ ही PDF में सहेज देता है। पेज बिल्कुल आपके असली जैसा दिखता है और शब्द वैसे ही काम करते हैं जैसे शब्दों को करना चाहिए।
कन्वर्ज़न शुरू करने से पहले OCR विकल्प चालू करें। इसे बंद छोड़ेंगे तो आपको एक पूरी तरह ठीक PDF मिलेगी, जो हर उस सर्च बॉक्स के लिए अपठनीय रहेगी जिसमें आप इसे कभी पेस्ट करेंगे।
JPG और JPEG एक ही इमेज फॉर्मेट हैं, बस फाइल एक्सटेंशन अलग हैं। पुराने Windows वर्ज़न तीन से ज़्यादा अक्षरों वाले फाइल एक्सटेंशन की अनुमति नहीं देते थे, इसलिए वे .jpg इस्तेमाल करते थे, जबकि Mac और UNIX सिस्टम .jpeg का उपयोग करते थे।
अब भले ही Windows कंप्यूटर लंबी .jpeg एक्सटेंशन वाली फाइलों को भी सपोर्ट करते हों, फिर भी तीन अक्षरों वाली एक्सटेंशन अधिक प्रचलित हो गई है। फाइल एक्सटेंशन में एक अतिरिक्त अक्षर को छोड़कर JPG और JPEG इमेज में कोई वास्तविक अंतर नहीं है।
यहां दोनों स्वीकार किए जाते हैं, और दोनों का PDF में कन्वर्ज़न एक जैसा होता है।
फाइल एक्सटेंशन: .jpg, MIME टाइप: image/jpeg
विकिपीडिया पर JPGडिफॉल्ट सेटिंग्स एक सामान्य इमेज को संभाल लेती हैं। वास्तव में सिर्फ OCR स्विच पर ही आपका ध्यान जरूरी है।
| सेटिंग | यह क्या करती है | कब बदलें |
|---|---|---|
| OCR का उपयोग करें | इमेज में मौजूद टेक्स्ट को पढ़कर PDF में असली टेक्स्ट के रूप में सहेजता है। | जब भी इमेज में ऐसा टेक्स्ट हो जिसे आप सुरक्षित रखना चाहते हैं, इसे चालू करें। |
| भाषा | टेक्स्ट पहचान को बताता है कि किस वर्णमाला और शब्दावली की उम्मीद करनी है। 124 भाषाएं उपलब्ध हैं। | इसे इमेज में मौजूद टेक्स्ट की भाषा पर सेट करें। |
| डेस्क्यू | टेढ़े स्कैन या फोटो को अपने आप सीधा करता है। | इसे हर उस चीज़ के लिए चालू करें जिसे हाथ से फोटो लिया गया हो या स्कैनर से कोण पर स्कैन किया गया हो। |
| PDF संस्करण | आउटपुट को किसी खास PDF स्पेसिफिकेशन (1.4 से 2.0) में लिखता है। | इसे वैसा ही छोड़ दें, जब तक कि कोई सिस्टम जिसे आप फाइल भेज रहे हैं, किसी खास वर्ज़न की मांग न करे। |
फ्री प्लान एक कन्वर्ज़न में 50 MB तक की 3 फाइलें लेता है, और हर JPG अपनी अलग PDF के रूप में वापस मिलता है।
रोजमर्रा की तीन स्थितियां, जहां ज़रूरी तस्वीर नहीं, बल्कि उसमें लिखा टेक्स्ट होता है।
बहुत से स्कैनर और स्कैनर ऐप सीधे JPG में सेव करते हैं। उस स्कैन की गई इमेज को OCR के साथ PDF में कन्वर्ट करने से आपको तस्वीरों का फोल्डर नहीं, एक ही डॉक्यूमेंट मिलता है, और टेक्स्ट भी उसके साथ चला आता है।
कॉन्ट्रैक्ट, फॉर्म या किताब के पेज की फोन से ली गई फोटो। डेस्क्यू इमेज को सीधा करता है, टेक्स्ट रिकग्निशन उसे पढ़ता है, और जो PDF आपको मिलती है, उसे किसी भी दूसरे डॉक्यूमेंट की तरह खोजा जा सकता है।
रसीदें, इनवॉइस और चिट्ठियां आम तौर पर इमेज के रूप में आती हैं। उन्हें टेक्स्ट रिकग्निशन के साथ PDF में बदलने पर वे एक बार फाइल की जा सकती हैं और बाद में रकम, नाम या रेफरेंस नंबर से खोजकर पाई जा सकती हैं।
अपनी JPG इमेज अपलोड करें।
अपनी इमेज में मौजूद टेक्स्ट को पहचानने के लिए OCR विकल्प चालू करें।
JPG में मौजूद टेक्स्ट की भाषा चुनें। (वैकल्पिक)
अगर आपकी फोटो या इमेज तिरछी है, तो डेस्क्यू सक्षम करें। (वैकल्पिक)
कन्वर्ज़न शुरू करें। थोड़ी देर बाद आप अपना PDF दस्तावेज़ डाउनलोड कर सकते हैं।
हां। OCR के साथ JPG को PDF में बदलना मुफ्त है और इसके लिए किसी अकाउंट की ज़रूरत नहीं है। इमेज अपलोड करें, OCR चालू करें, Start दबाएं और PDF डाउनलोड करें। सब्सक्रिप्शन सिर्फ बड़ी फाइलों और लंबी बैच प्रोसेसिंग के लिए मायने रखता है।
हां, जब तक आप शुरू करने से पहले OCR चालू रखते हैं। टेक्स्ट रिकग्निशन शब्दों को PDF में लिख देता है, ताकि उन्हें चुना, कॉपी किया और खोजकर पाया जा सके। OCR बंद होने पर PDF में सिर्फ तस्वीर ही रहती है।
उसी तरह, बस एक अतिरिक्त स्टेप के साथ। डेस्क्यू चालू करें और कोण पर खींची गई पेज की फोटो पहले सीधी कर दी जाती है, जो हाथ से ली गई फोटो को लगभग हमेशा चाहिए होता है। साफ, समान रोशनी वाली फोटो लगभग फ्लैटबेड स्कैन जितनी अच्छी तरह पढ़ी जाती है।
कुल 124, अंग्रेजी, स्पैनिश और पुर्तगाली से लेकर हिंदी, अरबी, रूसी और जापानी तक। शुरू करने से पहले वह भाषा चुनें जिसमें आपका पेज लिखा है, क्योंकि जब OCR को पता होता है कि कौन सी लिपि की उम्मीद करनी है, तो पहचान कहीं ज़्यादा सटीक होती है।
हां। जितनी ज़रूरत हो उतनी जोड़ें और सब एक बार में कन्वर्ट हो जाती हैं, हर फाइल अपनी अलग PDF के रूप में, उन्हीं सेटिंग्स के साथ लौटती है। फ्री प्लान एक कन्वर्ज़न में 50 MB तक की 3 फाइलें लेता है।
हां। JPG और JPEG एक ही फॉर्मेट हैं, बस फाइल एक्सटेंशन अलग हैं, और यहां दोनों स्वीकार किए जाते हैं। दूसरे आम इमेज फॉर्मेट भी काम करते हैं, इसलिए उसी पेज का TIF या BMP भी उतना ही अच्छी तरह कन्वर्ट हो जाता है।
इसके बजाय PDF ऐप्स में से किसी एक का। Make PDF searchable आपके पास पहले से मौजूद PDF में पहचाना गया टेक्स्ट जोड़ देता है, और PDF to text शब्दों को निकालकर एक प्लेन टेक्स्ट फाइल बनाता है। यह पेज इमेज फाइलों के लिए है।
इसे एन्क्रिप्टेड कनेक्शन के ज़रिए भेजा जाता है और यूरोप में मौजूद सर्वरों पर अपने आप प्रोसेस किया जाता है। कोई आपके फाइलें न पढ़ता है, न कॉपी करता है, उन्हें AI मॉडल ट्रेन करने के लिए इस्तेमाल नहीं किया जाता, और डाउनलोड लिंक रैंडम होता है ताकि उसे अनुमान से नहीं पाया जा सके।
यहाँ हर ऐप ब्राउज़र में चलता है, कुछ भी इंस्टॉल करने की ज़रूरत नहीं।